Aviso de maquila sin sorpresas
Un cliente de maquila avisa por WhatsApp de un cambio de última hora en la partida que trae a procesar. El mensaje llega tarde, cuando el turno ya está planificado con el volumen antiguo. Con iLEAN Connect, el sistema lee el aviso en el segundo cero.
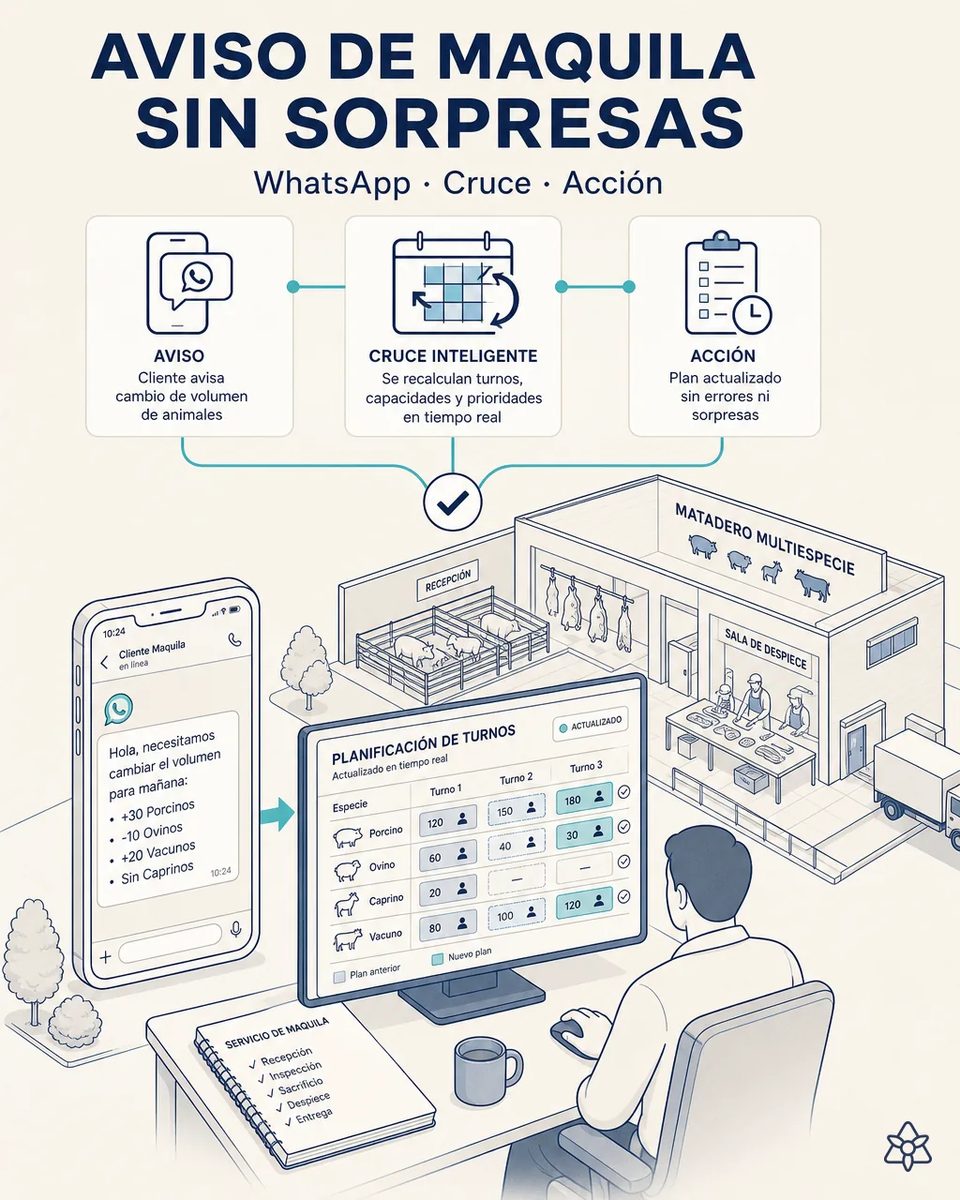
El negocio de maquila se planifica con datos que llegan por el canal equivocado.
El negocio de maquila depende de terceros, y los avisos de cambio llegan por canales personales a una sola persona.
- La partida que entra mañana la decide un tercero. El aviso de que trae treinta porcinos más y ningún caprino llega por mensajería, a una hora cualquiera, al móvil de una sola persona.
- Si esa persona está en línea, en el muelle o descansando, el mensaje espera. Mientras tanto el turno se cita con el volumen antiguo y la cuadrilla se convoca en vano.
- El aviso llega en lenguaje natural y sin formato: «mañana te subo unos veinte, los borregos déjalos para el jueves». Nadie lo pasa al sistema porque reescribirlo cuesta más que recordarlo.
- Y cuando el cliente reclama, no hay rastro de qué se avisó ni a qué hora, que es justo lo que decide quién asume el coste de un turno mal dimensionado. Y esa conversación siempre llega tarde, cuando la cuadrilla ya está pagada.
Connect en modo fuentes caóticas — el canal informal deja de ser un agujero.
Connect modo fuentes caóticas. Un LLM extrae cliente, especie, volumen y nueva fecha/hora, cruza con la planificación activa y devuelve la acción concreta.
El buzón y el número del servicio de maquila quedan en copia silenciosa las veinticuatro horas. El sistema extrae cliente, especie, cabezas y nueva fecha, los cruza con la planificación viva y devuelve la acción al rol que puede ejecutarla, no un aviso genérico a un grupo. El mensaje original queda guardado al lado de la propuesta, así que nadie tiene que fiarse de un resumen.
El aviso de hoy frente al aviso leído
| Aspecto | Hoy | Con iLEAN Connect |
|---|---|---|
| Latencia del aviso | Horas, según quién mire el móvil | Segundos |
| Dónde queda el mensaje | En un chat personal | Atado al cliente y a la partida |
| Reordenar el turno | A mano, si da tiempo | Propuesta con el cruce ya hecho |
| Cuadrilla citada en vano | Se descubre por la mañana | Se evita la tarde anterior |
| Quién asume el coste | Discusión sin registro | Hora y contenido del aviso, guardados |
| Dependencia de una persona | Total | Ninguna: el canal es del sistema |
horas de latencia humana → segundos.
Estimación de impacto — a validar con vuestros números.
El siguiente bloque es una estimación a validar con los datos concretos de tu planta. Lo planteamos para que el comité tenga un orden de magnitud; lo refinamos en el diagnóstico.
- Payback estimado 3-7 meses, según la frecuencia con la que vuestros clientes de maquila cambian la partida.
- De horas de latencia humana a segundos entre que el cliente escribe y el turno se replantea.
- Turnos citados con el volumen antiguo: el coste que nadie contabiliza porque no aparece en ningún parte. Se ve en el coste de personal del mes, ya mezclado con todo lo demás.
- Y cada aviso queda fechado y atado a su cliente, que es lo que zanja la discusión de quién paga un turno mal dimensionado.
Payback estimado 3-7 meses según frecuencia de incidencias de maquila. *Estimación a validar*.
Y la duda razonable del responsable de producción
«¿Y si interpreta mal un mensaje escrito de cualquier manera?» — aquí no se le pide al modelo que decida, se le pide que rellene cuatro huecos conocidos: cliente, especie, cabezas y fecha. Eso es tarea anclada, donde los mejores modelos bajan del 1,5% de error [1]. Y la propuesta de reprogramación no se aplica sola: llega al planificador como sugerencia, con el mensaje original al lado.
[1] Paper OpenAI «Why Language Models Hallucinate», 2025 — sobre fiabilidad de la IA en tareas ancladas.
Lo que preguntan sobre los avisos de los clientes de maquila
¿Hay que pedir a los clientes que escriban de otra forma?
No, y sería la manera de que dejaran de avisar. Se lee el mensaje tal y como lo escriben hoy, con sus abreviaturas y su forma de contar cabezas. Un «media docena de cerdas» se resuelve igual que un «6».
¿Entra también el correo, o solo la mensajería?
Ambos, y también el audio, que en maquila es la mitad de los avisos. Lo que llega por teléfono se dicta después en dos frases. Lo importante es que todos los canales acaben en el mismo sitio.
¿Se lee el móvil personal de alguien?
No. Se habilita un número o un buzón del servicio de maquila y se pide a los clientes que avisen ahí. Lo que llegue a un móvil personal se reenvía. Es un cambio de hábito pequeño y se asienta en una semana.
¿Qué pasa si dos clientes cambian la misma franja?
El cruce lo detecta y lo eleva. El sistema propone, pero una colisión de capacidad entre dos clientes la decide el planificador. El sistema no reparte capacidad entre clientes: eso es una decisión comercial.
¿Distingue un aviso en firme de una consulta?
Es parte de la extracción: un «¿podríais el jueves?» se marca como consulta pendiente de confirmar y no mueve la planificación. Cuando el cliente confirma, la propuesta se activa sobre el mismo hilo.
Otros casos de esta serie
- El módulo de calidad deja de estar vacíoiLEAN absorbe el control real y llena el módulo de calidad que tu ERP ya tenía construido, sin licencias…
- La etiqueta GS1-128 se rellena solaLos 20+ campos de la etiqueta logística se rellenan solos desde el lote activo del ERP.
- La guía y el crotal entran solosFoto a la guía sanitaria y al crotal: la tabla de trazabilidad animal se rellena sola, incluido el…
- El túnel de oreo queda registradoUna cámara externa lee la curva de temperatura del túnel de oreo sin tocar el controlador.
- Romaneo sin papel en líneaEl clasificador fotografía el parte de romaneo y el registro de canal ya existe en el sistema central en…
- Lo que se dice entre líneas quedaEl responsable de despiece dicta caminando entre especies y la IA lo estructura, guarda y responde en…
Contadnos cuántas veces al mes un cliente os cambia la partida con el turno ya citado.
Trabajamos sobre los datos reales de tu planta, no sobre los nuestros. Diagnóstico sin compromiso.
Pedir ROI estimado en 48h ‹ Ver todos los casos de matadero multiespecie Ver alimentaria